实习两周碎碎念来之前:感觉通勤1小时多还行吧
实习两周之后:已老实,下一份实习租房绝对控制在通勤40分钟以内😭(主要还是上海租房太贵了)
下班挺早的,但是回家都7点多快8点了,感觉自己的时间就没有了
上班也是,比想象的耗费精力,原本计划的还每天回去刷会儿力扣,学会儿东西呢,现在每天回去只想玩会游戏然后躺一会儿。下周要振作起来!
实习内容也还行,有一定算力,而且实习生的职务更像是一个探索者,去探索新的技术能否应用到业务里,这就造就了一个现象:正职天天在评测,调提示词,上线。实习生能去探索一些新东西,跑跑实验,体验很不错了。
这周干了一周的dirty work 接下来得好好学点东西了,好久没读论文,读论文能力都退化了,一个引言读了1个小时。。
继续加油!
孩子就想找个日常实习一个日常实习怎么这么难找/(ㄒoㄒ)/~~
不该拖延的,就该8月就开始投
这波学生思维了
有没有大佬看到捞一捞的 LLM 后训练、agent
从PPO到DPO的数学推导以及实现 前言 DPO的形式很简单,最终是在一个偏好对数据上进行直接训练 不再显式训练 Reward Model,也不需要 PPO 的强化学习过程,而是直接利用偏好数据优化语言模型。最终的优化目标为: 但这个式子怎么来的呢?实际上是从PPO中推导过来的 PPO 在 RL…
|
311
|
|
1421 字
|
6 分钟
RLHF中的PPO算法——TRL库的PPOTrainer源码分析 前言 上一次了解了RL中的PPO算法,这次我们去debug一个LLM训练框架的PPO算法是如何实现的,我们以hugging face的trl库中的PPOTrainer为例。看一下具体的PPO算法是如何实现的。 强化学习和监督学习的training loop的不…
|
386
|
|
2464 字
|
12 分钟
从0强化学习基础到理解PPO 前言 强化学习从deepseek-R1诞生之后已经就是LLM后训练必不可少的一个环节了,笔者是一个只有LLM基础的人,在这大半年里也是尝试过各种方式学习LLM后训练中的强化学习:试过直接啃PPO、GRPO,会感觉莫名其妙,首先是对强化学习和深度学习的训练方式差…
|
437
|
|
7822 字
|
30 分钟
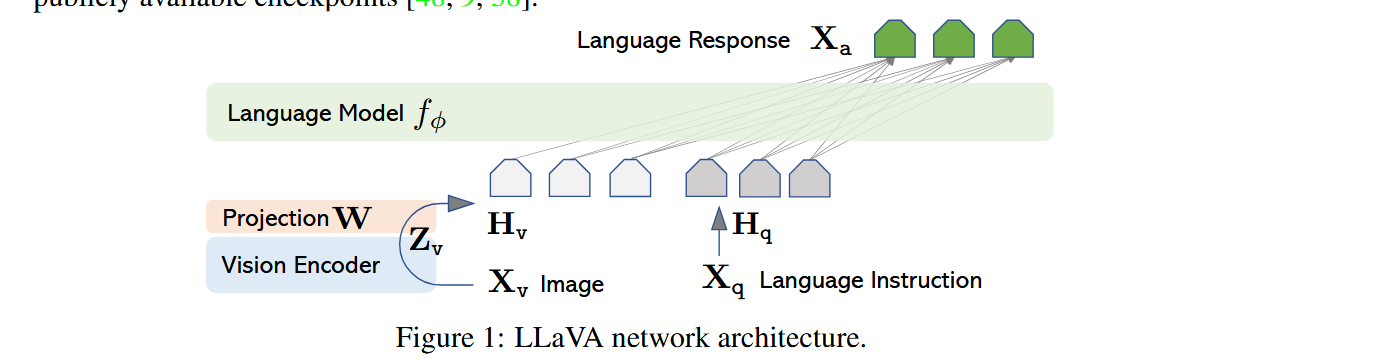
llava源码精读 Llava的结构 LLava的架构很简单就是在LLM的前面挂一个视觉encoder,这个encoder是预训练过的,LLava是用的CLIP的视觉encoder,但这里不是得到一个最终的图片向量,而是一个更细粒度的图片patch_token向量,然后再过一个P…
|
371
|
|
2220 字
|
16 分钟
RELU到SwiGLU:LLM中FFN层的演变 原始transformer的FFN层 原始transformerFFN层非常简单,就是一个升维+降维的操作,中间套一个RELU激活函数: FFN层的作用是增加模型的非线性能力,升维再降维的操作也是老传统了,之前学从感知机到多层感知机就明白,一个低的维度的特征终…
|
401
|
|
1029 字
|
5 分钟
MHA、MQA、GQA小结 多头注意力(Multi-head Attention,MHA) 原始transformer架构的多头注意力是将QKV拆成多个头,对于(batch_size,seq_len,d_model)维度的QKV向量拆成:(batch_size,seq_len,head_…
|
375
|
|
1164 字
|
9 分钟
从 LayerNorm 到 RMSNorm:为什么可以去掉均值? 在现代 LLM 中,RMSNorm 已经成为非常常见的归一化方式。它可以看作是 LayerNorm 的一个简化版本。 要理解 RMSNorm,最自然的方式是先从 LayerNorm 开始。 1. LayerNorm 在做什么? 对于一个 hidden stat…
|
324
|
|
1083 字
|
5 分钟
CLIP、SigLIP、SigLIP2小结 写在前面:这个文章是我快速回顾这些知识点的输出,出发点并不是写一个易懂的知识博客,读者多多包涵。 CLIP CLIP的结构非常简单,输入端是图文对,训练数据中的图文对是具有强相关的,即文本就是图片的描述。 然后图片和文本都会经过一个编特征提取器,一般图片是用R…
|
301
|
|
2956 字
|
16 分钟